ODKRYWAJ MODELE AI
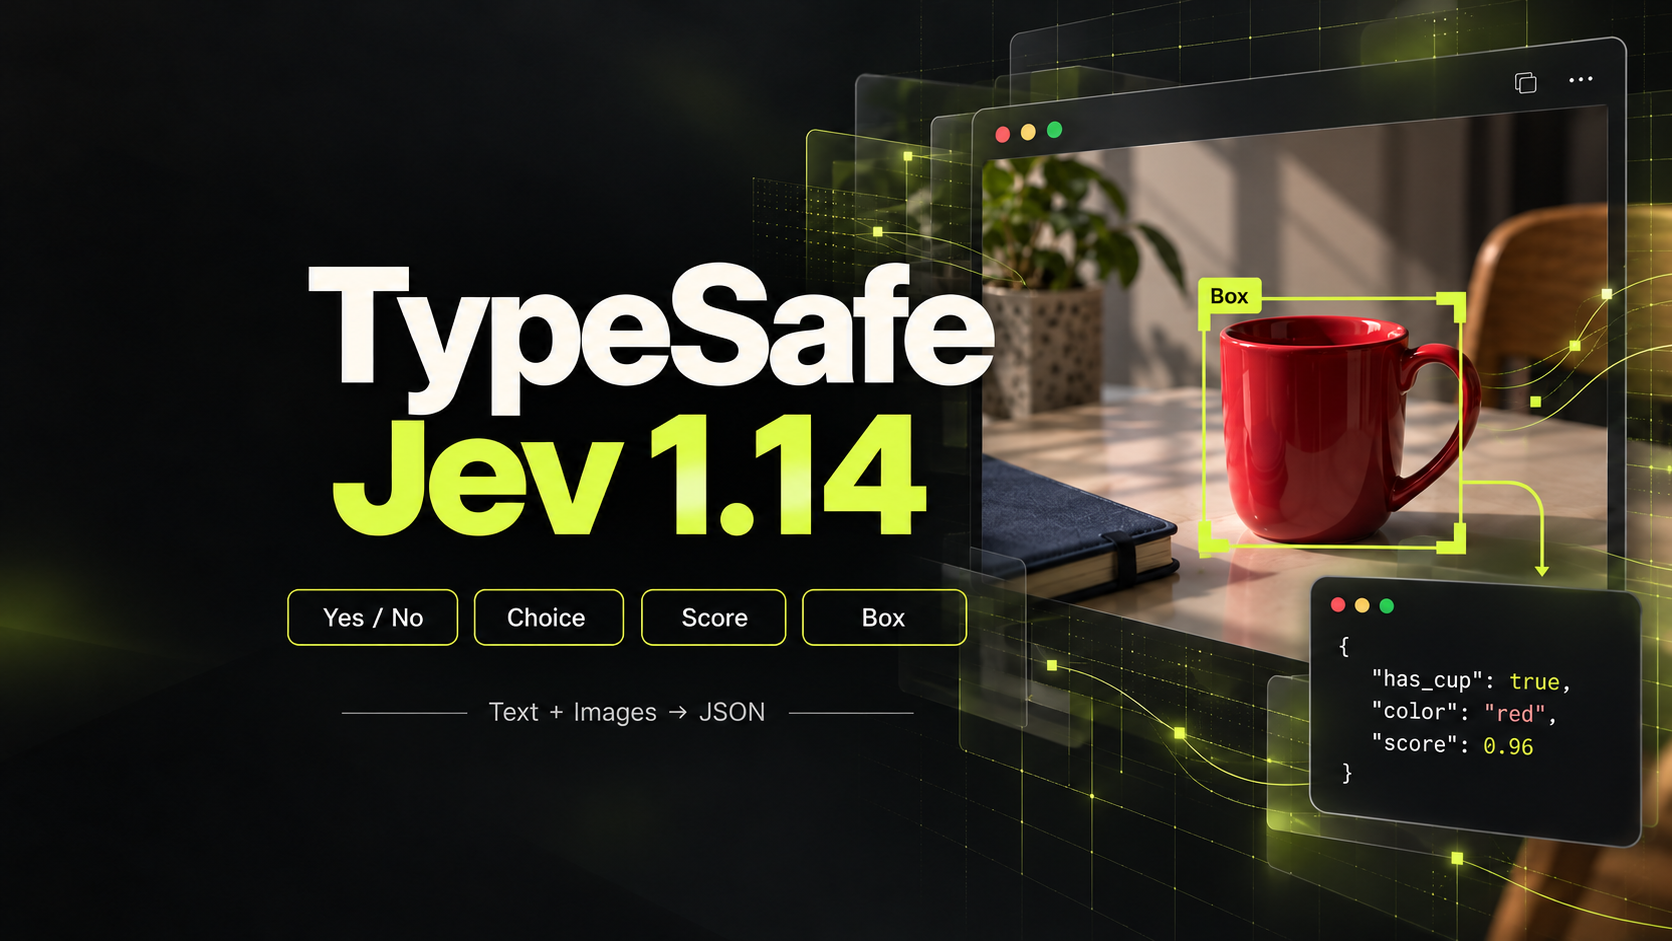
 TypeSafe
 Jev 1.14
Structured multimodal decisions from text, JSON, and inline images.
Odkryj generowanie wideo AI z dźwiękiem dla swoich scen
DOSTAWCY
 Black Forest Labs
 Kling
 Lightricks
 OpenAI
 Runway
 SeeAPI








Oś czasu premier modeli
Vidu Q4
ViduVidu Q4 preview video generation with image or multi-reference guidance, audio, up to 16 seconds, and up to 4K output.
Wan 3.0 Prime
AlibabaGenerowanie wideo Alibaba Wan 3.0 Prime z referencjami tekstowymi, obrazowymi, wideo, audio, dokumentami i stronami internetowymi.
Wan 3.0
AlibabaGenerowanie wideo Alibaba Wan 3.0 z referencjami tekstowymi, obrazowymi, wideo, audio, dokumentami i stronami internetowymi.
Gemini Omni Flash 1.1
GoogleGemini Omni Flash 1.1 video generation with image, video, audio, and character references.
Seedance 2.5
ByteDanceModel wideo nowej generacji ByteDance do dłuższych narracji, obsługujący do 50 multimodalnych materiałów referencyjnych
MiniMax H3
MiniMaxMultimodalne generowanie wideo z natywnym dźwiękiem w MiniMax H3 (Hailuo 03), z obsługą wyjścia do 2K.
Seedance 2.0 Mini
ByteDanceEkonomiczny model wideo Seedance 2.0 firmy ByteDance, zapewniający szybsze generowanie i niższe koszty wnioskowania
Seedance 2.0 Fast
ByteDanceSzybkie i przystępne cenowo wideo multimodalne z tekstem, obrazem, wideo i dźwiękiem do 720p
Grok Imagine Video 1.5
GrokGenerowanie wideo z obrazu za pomocą xAI Grok Imagine Video 1.5
Wan 2.7
AlibabaAPI Wan 2.7 firmy Alibaba obsługuje pełną modalność wejść (tekst, obraz, wideo, audio) dla czterech trybów (T2V, I2V, Reference2V, Edit), dostarczając materiały w rozdzielczości 720P–1080P.
Zaplanuj obraz i dźwięk razem
Generowanie wideo AI z dźwiękiem łączy ruchomy obraz z generowanym audio. Określ słyszalne zdarzenia w scenie i sprawdź możliwości wybranego modelu.
Opisz to, co słychać
Powiąż dźwięk z widoczną akcją, na przykład krokami lub odstawieniem kubka. Rozdziel dialog i tło.
Zweryfikuj opcje audio
Przełączniki, języki i referencje dźwiękowe różnią się między endpointami. Etykieta kategorii nie oznacza identycznych funkcji.
Odsłuchaj wynik
Podgląd może być wyciszony. Sprawdź właściwy plik, synchronizację, zrozumiałość mowy i niepożądane dźwięki.
Od wyboru modelu do pierwszego żądania
Zacznij od małego, reprezentatywnego testu i dokumentacji wybranego endpointu.
Przygotuj opis audiowizualny
Zdefiniuj scenę i najważniejsze dźwięki.
Sprawdź konfigurację
Zweryfikuj tryb audio, wejście i cenę.
Obejrzyj i odsłuchaj
Oceń synchronizację i spójność obrazu, zachowując parametry testu.
Generowanie wideo AI z dźwiękiem: najczęstsze pytania
Poznaj możliwości i ograniczenia przed integracją.
Model tworzy dźwięk w ramach generowania wideo, zamiast dodawać osobną ścieżkę później w edytorze.